Cluster Galera e HAProxy per WooCommerce: analisi tecnica di un'architettura open source ad alta affidabilità
Cluster MariaDB Galera e HAProxy per WooCommerce: come funziona un'architettura open source a 3 nodi, dove si rompe e cosa serve per la produzione.
In questo articolo
- In sintesi: cosa dimostra il laboratorio
- L'architettura del laboratorio
- Come funziona il cluster Galera, senza semplificazioni sbagliate
- HAProxy: l'unico punto d'ingresso al database
- Avvio e spegnimento: il problema che quasi tutti sottovalutano
- Analisi critica: cosa funziona e cosa manca per la produzione
- Quale livello di affidabilità serve davvero alla tua azienda
- Il valore dell'open source per le aziende
- Come lavoriamo su questi progetti in TN Solutions
Un cluster MariaDB Galera di tre nodi con HAProxy davanti è uno dei modi più solidi per tenere in piedi il database di un e-commerce WooCommerce anche quando un server si guasta, usando solo software open source e senza licenze. In questo articolo smontiamo pezzo per pezzo un laboratorio costruito dal nostro team tecnico, spieghiamo cosa fa bene, dove si rompe e cosa serve per portarlo in produzione in un'azienda vera.
Non è una guida di installazione. È l'analisi che facciamo quando un cliente ci chiede: "il mio negozio online, il mio gestionale web o il mio portale possono restare operativi se cade un server, senza comprare licenze enterprise?". La risposta breve è sì, a patto di progettare bene tre cose: il database, il punto d'ingresso e le procedure di ripartenza.
In sintesi: cosa dimostra il laboratorio
- Il database del negozio sopravvive alla caduta di un nodo. Tre nodi MariaDB Galera tengono ciascuno una copia completa dei dati, e un ordine viene confermato solo dopo che il cluster lo ha certificato.
- L'applicazione se ne accorge al massimo per qualche secondo. WordPress parla con un solo indirizzo (HAProxy): le richieste in corso sul nodo caduto falliscono, quelle successive vanno al nodo vivo.
- La ripartenza dopo uno spegnimento è automatica, grazie a uno script che sceglie il nodo giusto da cui rifondare il cluster.
- Tutto è open source: Ubuntu Server, Apache, PHP, ISPConfig, MariaDB, Galera, HAProxy e Docker.
- Ma un laboratorio non è un'infrastruttura di produzione. Sta tutto su una sola macchina virtuale, e il controllo di salute di HAProxy non vede lo stato reale di Galera. Più avanti spieghiamo come si chiudono questi limiti.
L'architettura del laboratorio
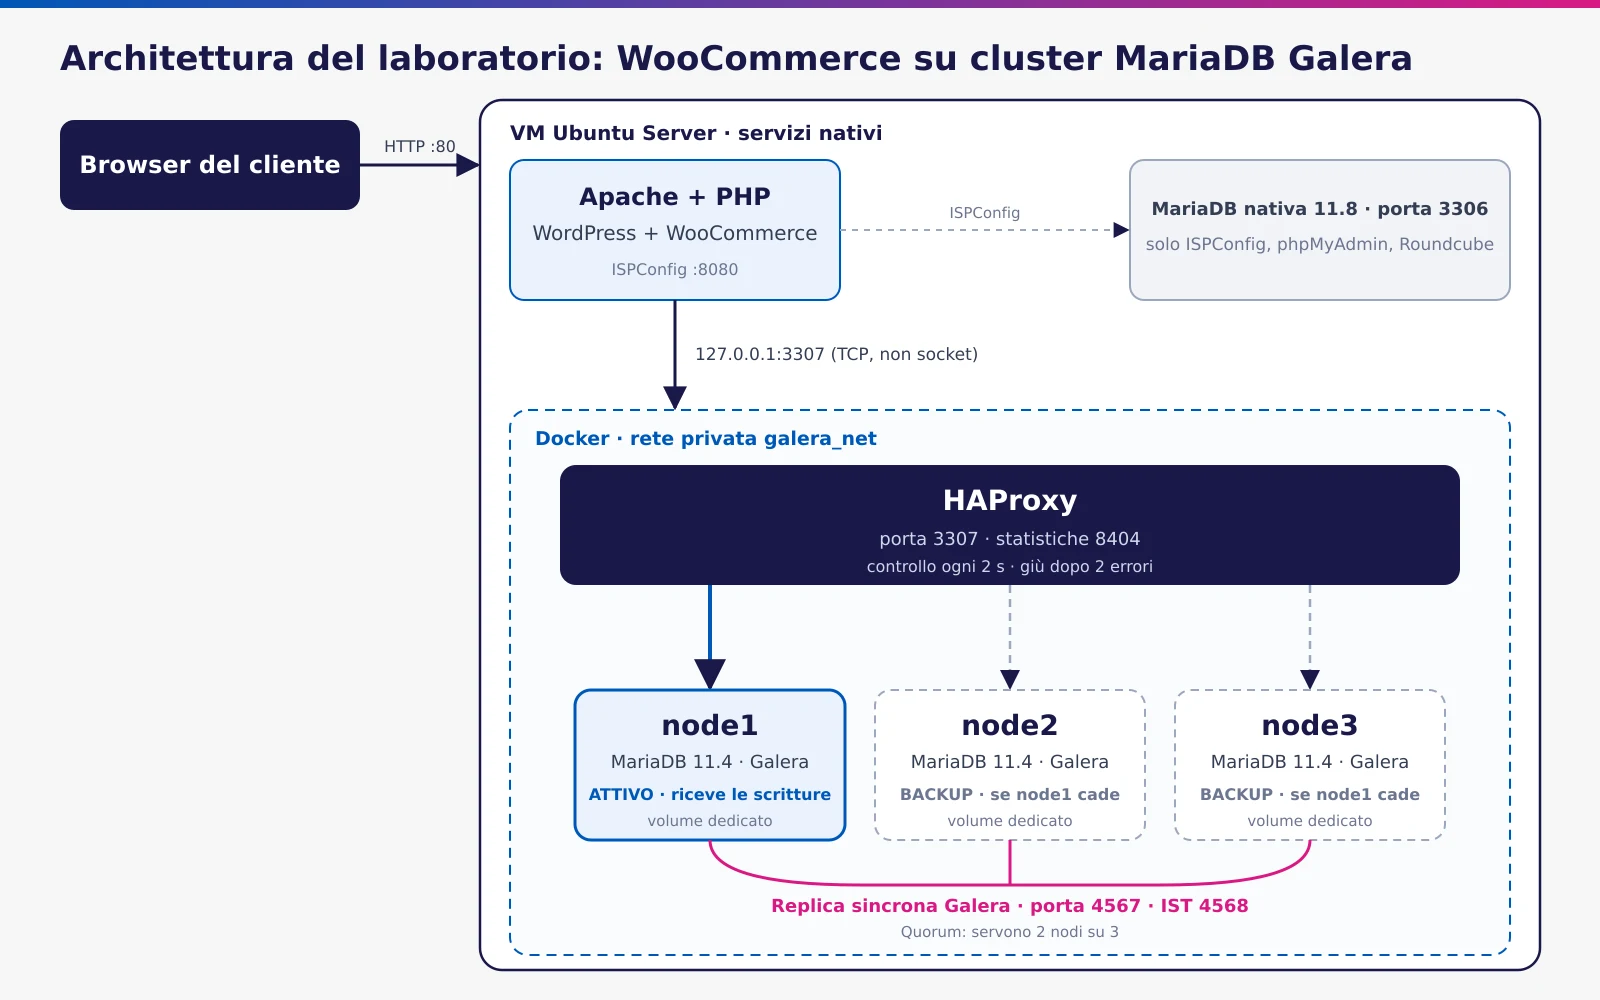
Il laboratorio è un negozio WordPress con WooCommerce su una sola VM Ubuntu Server (3 GB di RAM, 40 GB di disco su LVM, rete in bridge con IP fisso). La VM ha due ruoli:
- Ospita i servizi nativi: Apache, PHP, il pannello di hosting ISPConfig e una MariaDB di sistema.
- Fa da host Docker per il cluster che contiene il database del negozio.
Livello web: Apache, PHP e ISPConfig
Il livello web è installato direttamente sulla VM e gestito con ISPConfig, un pannello di hosting open source paragonabile a cPanel o Plesk. Apache riceve le richieste e sceglie il sito in base al nome (VirtualHost), PHP esegue WordPress, e ISPConfig crea siti, database e utenti di sistema senza modifiche manuali ai file. Ogni sito vive nella propria cartella con un utente dedicato, così resta isolato dagli altri.
Due database con compiti separati
È una scelta di progetto che consigliamo sempre, anche fuori dal laboratorio:
| Database | Dove gira | Porta | Contiene |
|---|---|---|---|
| MariaDB nativa 11.8 | Servizio di sistema | 3306 | Solo i database interni di ISPConfig, phpMyAdmin e Roundcube |
| Cluster Galera (MariaDB 11.4) | Tre container Docker | 3307, tramite HAProxy | Solo il database del negozio |
Il pannello non può fare a meno della sua MariaDB, quindi resta dov'è. Il negozio invece vive su un database separato: si può lavorare sul cluster, fermarlo o ricostruirlo senza toccare il pannello, e viceversa. Separare i dati di gestione da quelli di business riduce il raggio d'azione di ogni guasto e di ogni manutenzione.
Il collegamento di WordPress al cluster
In wp-config.php WordPress punta a 127.0.0.1:3307. Il dettaglio non è banale: con localhost il client MySQL di PHP prova il socket Unix locale e finirebbe sulla MariaDB nativa, non sul cluster. È un errore classico che produce un sito "funzionante" ma collegato al database sbagliato.
Nel database ci sono prodotti, ordini, clienti, impostazioni e anche le sessioni e i carrelli di WooCommerce. I file (codice, plugin, tema, immagini caricate) restano invece sul disco della VM.
Docker: container, volumi e rete
| Container | Immagine | Ruolo | Porte esposte alla VM |
|---|---|---|---|
| node1, node2, node3 | mariadb:11.4 | Nodi Galera | Nessuna |
| haproxy | haproxy:lts | Proxy davanti ai nodi | 3307 (database), 8404 (statistiche) |
Tre elementi tengono insieme il livello:
- Volumi dedicati: ogni nodo salva i dati in un volume proprio. I container si possono ricreare, i dati restano.
- Rete privata: i quattro container si trovano per nome su una rete interna; dall'esterno si raggiunge solo HAProxy.
- Configurazione dichiarativa: un file Compose descrive tutto, la configurazione Galera è comune a tutti i nodi e le password stanno in un file
.envcon permessi ristretti.
Tutti i container hanno la policy unless-stopped: se uno cade da solo, Docker lo riavvia. Dopo un riavvio dell'host, però, i nodi Galera non devono ripartire tutti insieme per conto proprio: la policy va coordinata con lo script di avvio descritto più avanti e provata in collaudo, altrimenti i nodi senza un fondatore entrano in un ciclo di riavvii.
Come funziona il cluster Galera, senza semplificazioni sbagliate
I tre nodi formano il cluster store_cluster e ognuno ha una copia completa del database. Ecco i concetti che contano davvero quando si deve garantire la continuità di un servizio.
Replica "virtualmente sincrona". Al commit, la transazione viene inviata a tutti i nodi e certificata: ogni nodo esegue la stessa verifica deterministica, quindi tutti arrivano allo stesso esito. Nessun ordine confermato può andare perso per la caduta di un nodo. L'applicazione delle modifiche sugli altri nodi però avviene subito dopo, in modo asincrono: per qualche millisecondo un nodo può essere leggermente indietro. Con un solo nodo che scrive e legge, come nel laboratorio, il problema non si pone; se si distribuiscono le letture su più nodi va attivato wsrep_sync_wait sulle letture critiche.
Multi-master, usato come single-writer. Tutti i nodi possono accettare scritture, ma due scritture contemporanee sulla stessa riga da nodi diversi generano un conflitto di certificazione, che l'applicazione riceve come deadlock. WooCommerce aggiorna spesso le stesse righe (scorte, sessioni, opzioni), quindi la scelta del laboratorio, un solo nodo che scrive alla volta, è quella corretta.
Quorum. Il cluster lavora solo se vede la maggioranza dei nodi: con tre nodi ne servono due. Per questo i nodi sono tre: con due, la perdita improvvisa di uno (crash o guasto di rete) lascia l'altro senza maggioranza e il cluster si ferma. Il quorum evita lo split brain, cioè due gruppi isolati che si credono entrambi il cluster valido e divergono.
Rientro di un nodo: IST e SST. Un nodo che torna dopo una breve assenza recupera solo le transazioni mancanti (IST, porta 4568) dalla cache di replica dei compagni, la gcache. Se è rimasto fuori troppo a lungo riceve una copia completa (SST). Il laboratorio usa rsync, che blocca il nodo donatore per tutta la durata della copia.
Flow control. Se un nodo applica le modifiche più lentamente degli altri, il cluster rallenta tutti per aspettarlo. Un nodo su un disco lento o con poca RAM peggiora le prestazioni dell'intero cluster: le risorse vanno dimensionate in modo uniforme.
La configurazione comune del laboratorio è essenziale e corretta:
[galera]
wsrep_on                 = ON
wsrep_provider           = /usr/lib/galera/libgalera_smm.so
wsrep_cluster_name       = store_cluster
wsrep_cluster_address    = gcomm://node1,node2,node3
wsrep_sst_method         = rsync
binlog_format            = ROW
default_storage_engine   = InnoDB
innodb_autoinc_lock_mode = 2
bind-address             = 0.0.0.0
binlog_format = ROW e innodb_autoinc_lock_mode = 2 sono requisiti di Galera, non preferenze. Nome e indirizzo di ciascun nodo stanno nel file Compose, e ogni nodo usa un buffer InnoDB ridotto a 128 MB per stare nella memoria della VM.
HAProxy: l'unico punto d'ingresso al database
WordPress non sa che esiste un cluster: parla con HAProxy, che inoltra ogni connessione a un nodo vivo. Se vuoi approfondire il funzionamento generale del bilanciatore, trovi la spiegazione completa nella nostra guida su che cos'è HAProxy e come funziona.
Nel laboratorio HAProxy è configurato così:
- Un nodo attivo, due di riserva. Tutte le connessioni vanno a node1; node2 e node3 sono marcati
backupe ricevono traffico solo se node1 è giù. Così, di norma, scrive un nodo alla volta. - Controlli di salute ogni 2 secondi, con un utente dedicato senza password né permessi sui dati, limitato alla rete interna. Un nodo è giù dopo 2 controlli falliti e torna in servizio dopo 3 riusciti.
- Nuovo tentativo immediato (
retrieseoption redispatch): se l'apertura di una connessione fallisce, HAProxy la riprova su un altro nodo. Le query già partite sul nodo che cade invece falliscono, quindi durante un guasto qualche richiesta può andare in errore per pochi secondi. - Risoluzione dinamica dei nomi tramite il DNS interno di Docker: HAProxy può partire prima dei nodi e segue i loro IP quando vengono ricreati.
- Pagina di statistiche sulla porta 8404, con lo stato di ogni nodo in tempo reale.
Ogni pagina di WordPress apre una connessione nuova al database, ed è questo che rende il cambio di nodo trasparente: la richiesta successiva va semplicemente al nodo vivo, e il carrello resta perché sta nel database replicato.
Avvio e spegnimento: il problema che quasi tutti sottovalutano
Un cluster Galera spento del tutto non sa ripartire da solo. Il gruppo esiste finché almeno un nodo è acceso; se si fermano tutti, qualcuno deve rifondarlo con il flag --wsrep-new-cluster, e deve essere il nodo con i dati più recenti. Se si sceglie il nodo sbagliato, si perdono le ultime transazioni.
Il laboratorio risolve il problema con un servizio systemd e uno script di avvio:
- Allo spegnimento ferma i nodi in ordine (node3, node2, node1): l'ultimo a uscire si segna
safe_to_bootstrap: 1nel filegrastate.dat. - All'avvio aspetta 20 secondi e controlla se un cluster è già attivo; se sì, non fa nulla.
- Legge
safe_to_bootstrapdal volume di ogni nodo. - Se un solo nodo ha il flag, lo avvia in modalità bootstrap usando un file Compose temporaneo, senza toccare quello principale.
- Avvia gli altri due uno alla volta, aspettando che ciascuno sia
Synced. - Ricrea il nodo fondatore senza il flag, così al riavvio successivo rientra nel cluster invece di fondarne un altro.
- Scrive ogni passaggio in un log dedicato.
Se nessun nodo, o più di uno, ha il flag, lo script si ferma e lascia un avviso. È la scelta giusta: un'automazione che in caso di dubbio si ferma è molto meglio di una che indovina.
| Tipo di spegnimento | Esempi | Cosa succede al riavvio |
|---|---|---|
| Ordinato | shutdown, reboot, arresto del guest dall'hypervisor |
Cluster e sito ripartono da soli in circa un minuto |
| Brusco | Power off della VM, blocco, mancanza di corrente | Nessun nodo è marcato sicuro: serve il recupero manuale con mariadbd --wsrep-recover, scegliendo il nodo con il seqno più alto |
In entrambi i casi i dati restano nei volumi. Con l'impostazione predefinita innodb_flush_log_at_trx_commit = 1, dopo un crash si perde al massimo la transazione che non era ancora stata confermata; con valori diversi, a volte usati su Galera per guadagnare prestazioni, uno spegnimento simultaneo di tutti i nodi può costare gli ultimi istanti. Galera prevede anche un recupero automatico della componente primaria (pc.recovery), che in diversi scenari evita il bootstrap manuale dopo un'interruzione simultanea: va però verificato in collaudo, non dato per scontato.
Analisi critica: cosa funziona e cosa manca per la produzione
Questa è la parte che interessa a chi deve decidere. Il laboratorio è progettato bene, ma per una scelta consapevole concentra tutto su una macchina. Ecco cosa terremmo e cosa cambieremmo.
I punti di forza da portare in produzione
- Database applicativo separato da quello del pannello.
- Un solo writer scelto dal bilanciatore: niente conflitti di certificazione nel funzionamento normale.
- Connessione via TCP a un indirizzo unico: l'applicazione non conosce la topologia e non va modificata se il cluster cambia.
- Procedura di bootstrap automatica e prudente, con log.
- Configurazione dichiarativa e segreti fuori dal Compose.
I limiti e come si chiudono
1. Un solo punto di guasto fisico. Tre nodi sulla stessa VM proteggono dal crash di un processo, non dal guasto del server, del disco o dell'hypervisor. In produzione i nodi vanno su tre host fisici distinti, ad esempio un cluster Proxmox con regole di anti-affinità, oppure due nodi più un arbitro leggero (garbd) su una terza macchina. I nodi devono stare su una rete a bassa latenza: la replica sincrona paga ogni millisecondo di distanza su ogni commit.
2. Il controllo di salute non conosce Galera. Il controllo mysql-check verifica solo che MariaDB accetti la connessione. Un nodo isolato dal quorum (non-Primary) o che sta rientrando nel cluster accetta connessioni ma rifiuta le query con l'errore "WSREP has not yet prepared node for application use". HAProxy lo considererebbe sano e il sito andrebbe in errore. In produzione si usa un controllo che legge wsrep_local_state_comment e wsrep_cluster_status: uno script in stile clustercheck (non incluso nell'immagine MariaDB) esposto sulla porta 9200 da un servizio dedicato e interrogato con option httpchk, oppure un proxy consapevole di Galera come ProxySQL.
backend galera_writer
    option httpchk
    default-server inter 2s fall 2 rise 3 on-marked-down shutdown-sessions on-marked-up shutdown-backup-sessions
    server node1 10.0.10.11:3306 check port 9200
    server node2 10.0.10.12:3306 check port 9200 backup
    server node3 10.0.10.13:3306 check port 9200 backup
Lo schema è un estratto (il mode tcp sta nella sezione defaults). Con on-marked-down shutdown-sessions le connessioni rimaste aperte sul nodo caduto vengono chiuse subito, invece di restare appese fino al timeout. Con on-marked-up shutdown-backup-sessions, quando node1 rientra, le sessioni rimaste sui nodi di riserva vengono chiuse: senza questa opzione, per qualche tempo scriverebbero due nodi insieme, con il rischio di conflitti e deadlock che la scelta single-writer voleva evitare.
3. HAProxy stesso è un punto singolo. Se cade il container o la macchina che lo ospita, il database è irraggiungibile anche con tre nodi sani. Le soluzioni tipiche sono due istanze HAProxy con un IP virtuale gestito da keepalived (VRRP), oppure un HAProxy locale su ogni server web.
4. Il livello web non è ridondato. WordPress, i plugin e le immagini caricate stanno su un solo disco. Per un e-commerce davvero ad alta affidabilità servono almeno due nodi web dietro un bilanciatore HTTP, uno storage condiviso o sincronizzato per wp-content/uploads, una cache a oggetti (Redis) e un processo di deploy che aggiorni tutti i nodi insieme.
5. Trasferimento completo bloccante. Con rsync il nodo donatore resta bloccato per tutta la copia. In produzione si usa wsrep_sst_method = mariabackup, che lascia il donatore operativo con blocchi molto brevi, e si dimensiona la gcache (gcache.size) in modo che un nodo fermo per una manutenzione di qualche ora rientri con un IST invece che con una copia completa.
6. Il cluster non è un backup. Un DROP TABLE, un plugin che corrompe i dati o un ransomware che cifra il database si replicano su tutti e tre i nodi in pochi millisecondi. Servono backup giornalieri con mariabackup, preferibilmente eseguiti su un nodo che non riceve il traffico, i binlog per il ripristino a un punto preciso nel tempo (con log_bin e wsrep_gtid_mode attivi su ogni nodo), una copia fuori sede e prove di ripristino periodiche. Ne parliamo nella guida su backup e disaster recovery per le PMI.
7. Sicurezza del traffico di replica. Sulla rete interna di Docker il traffico tra i nodi resta sulla stessa macchina; quando i nodi sono su host diversi, replica (4567), IST (4568) e SST (4444) viaggiano in chiaro se non si attiva TLS. Vanno cifrati e filtrati dal firewall. Anche la pagina statistiche di HAProxy va protetta con autenticazione e non esposta all'esterno.
8. Compatibilità dell'applicazione. Galera replica solo tabelle InnoDB e lavora male con tabelle senza chiave primaria, transazioni enormi e LOCK TABLES. WordPress core è compatibile, ma ogni plugin che crea tabelle proprie va verificato prima della migrazione, così come le importazioni massive di prodotti, da spezzare in lotti anche per rispettare i limiti wsrep_max_ws_size e wsrep_max_ws_rows.
9. Monitoraggio. Un cluster che degrada in silenzio è un cluster che un giorno si ferma all'improvviso. Le metriche minime sono wsrep_cluster_size, wsrep_cluster_status, wsrep_local_state_comment, wsrep_flow_control_paused e la coda di ricezione, più lo stato dei backend in HAProxy, con allarmi a chi può intervenire. Approfondiamo indicatori e strumenti nell'articolo sul monitoraggio server.
Quale livello di affidabilità serve davvero alla tua azienda
Non tutti i siti hanno bisogno di un cluster. Questa tabella riassume le opzioni che valutiamo con i clienti, dalla più semplice alla più robusta.
| Soluzione | Cosa protegge | Perdita dati possibile | Tempo di ripristino tipico | Complessità |
|---|---|---|---|---|
| Server singolo + backup notturno | Errori e disastri, con ritardo | Fino a 24 ore | Ore | Bassa |
| Primario + replica asincrona | Guasto del server, con failover manuale o scriptato | Pochi secondi | Minuti | Media |
| Cluster Galera 3 nodi + HAProxy ridondato | Guasto di un nodo, manutenzioni senza fermo | Nessuna transazione confermata | Secondi, automatico | Medio-alta |
| Galera + web ridondato + backup fuori sede | Guasto di qualunque componente singolo e disastri | Nessuna transazione confermata; fino all'ultimo backup per i disastri | Secondi per i guasti, ore per i disastri | Alta |
La scelta dipende da una domanda concreta: quanto costa un'ora di fermo? Per un e-commerce che fattura nelle ore di punta, per un portale B2B con ordini automatici o per un gestionale web usato dai reparti operativi, il cluster si ripaga presto. Per un sito vetrina con poco traffico, un buon backup con un ripristino testato è spesso la scelta più sensata.
Il valore dell'open source per le aziende
Tutta l'architettura gira su software libero: nessun costo di licenza, nessun vincolo con un fornitore, codice verificabile e una comunità molto ampia. Le funzioni di alta affidabilità per i database, che nei prodotti commerciali sono spesso legate alle edizioni enterprise, qui sono disponibili fin dal primo nodo.
Il costo però non sparisce: si sposta dalle licenze alle competenze. Progettazione, collaudo dei guasti, aggiornamenti coordinati, monitoraggio e procedure di ripartenza richiedono un sistemista che conosca Galera, HAProxy e Linux in profondità. È lo stesso discorso che facciamo nell'articolo sul ruolo del sistemista Linux in azienda: l'open source conviene quando qualcuno se ne prende cura in modo continuativo. Per un confronto più ampio tra le piattaforme dati trovi anche la nostra panoramica sui migliori database open source e commerciali, e una presentazione generale di MariaDB e MariaDB Cluster.
Come lavoriamo su questi progetti in TN Solutions
Con oltre 25 anni come System Integrator B2B, seguiamo questi progetti dall'analisi alla gestione quotidiana:
- Analisi: obiettivi di disponibilità (RPO e RTO), costo del fermo, compatibilità dell'applicazione e dei plugin.
- Progettazione: scelta del livello di ridondanza, distribuzione dei nodi sull'infrastruttura di virtualizzazione, rete, sicurezza e backup.
- Laboratorio e collaudo: esattamente come quello descritto qui, con prove di guasto, spegnimenti bruschi e ripristini prima di toccare la produzione.
- Migrazione del database con finestre di intervento concordate.
- Gestione continuativa: monitoraggio, aggiornamenti, verifiche dei backup e intervento in caso di guasto, all'interno dei nostri contratti di assistenza informatica.
Se vuoi capire se un'architettura di questo tipo ha senso per il tuo e-commerce o per le tue applicazioni, la nostra consulenza sistemistica parte proprio da un'analisi dell'infrastruttura esistente. Per i server già in uso offriamo assistenza sistemistica e assistenza server aziendali. Un esempio di come progettiamo infrastrutture e-commerce è il caso studio sull'architettura infrastrutturale di Initpc.
Contattaci per una prima valutazione tecnica.
Domande frequenti
Quanti nodi servono per un cluster Galera affidabile?
Almeno tre, oppure due nodi più un arbitro (garbd) su una terza macchina. Il cluster lavora solo se vede la maggioranza dei nodi: con due soli nodi, la perdita improvvisa di uno lascia l'altro senza maggioranza e il cluster si ferma per evitare lo split brain.
Galera Cluster sostituisce il backup?
No. La replica copia su tutti i nodi anche gli errori: una tabella cancellata o un database cifrato da un ransomware spariscono ovunque nello stesso istante. Il cluster protegge dai guasti hardware, il backup protegge dagli errori e dai disastri. Servono entrambi.
WooCommerce funziona su un cluster MariaDB Galera?
Sì. WordPress e WooCommerce usano tabelle InnoDB con chiave primaria e funzionano bene su Galera, soprattutto con un solo nodo che riceve le scritture. Vanno verificati i plugin che creano tabelle proprie o usano LOCK TABLES, e le importazioni massive vanno spezzate in lotti.
Perché usare HAProxy davanti al cluster invece di collegarsi direttamente a un nodo?
Perché l'applicazione deve avere un indirizzo unico che resta valido anche quando un nodo cade. HAProxy controlla continuamente lo stato dei nodi, manda le connessioni solo a quelli sani e permette di avere un solo nodo che scrive alla volta, evitando i conflitti tra scritture contemporanee. Le richieste in corso sul nodo che cade possono fallire, ma le successive vanno subito al nodo sano.
Si può far girare un cluster Galera in Docker in produzione?
Sì, con volumi persistenti, risorse dedicate e nodi su host fisici diversi. Docker semplifica la ricreazione dei nodi e la gestione delle versioni; molte aziende preferiscono comunque VM o container LXC su Proxmox per avere il cluster integrato con il resto dell'infrastruttura virtualizzata e con i suoi backup.
Cosa succede se tutti i nodi si spengono di colpo?
I dati restano sui volumi, ma il cluster va rifondato dal nodo più aggiornato. Si individua con mariadbd --wsrep-recover, che restituisce il numero dell'ultima transazione applicata da ogni nodo, e su quello con il valore più alto si imposta safe_to_bootstrap: 1 in grastate.dat prima di avviarlo con --wsrep-new-cluster. Avere questa procedura documentata e provata è parte del progetto, non un dettaglio.
Partner tecnologici
Vuoi parlarne con un nostro tecnico?
Analizziamo gratuitamente la tua infrastruttura e ti proponiamo la soluzione più adatta.